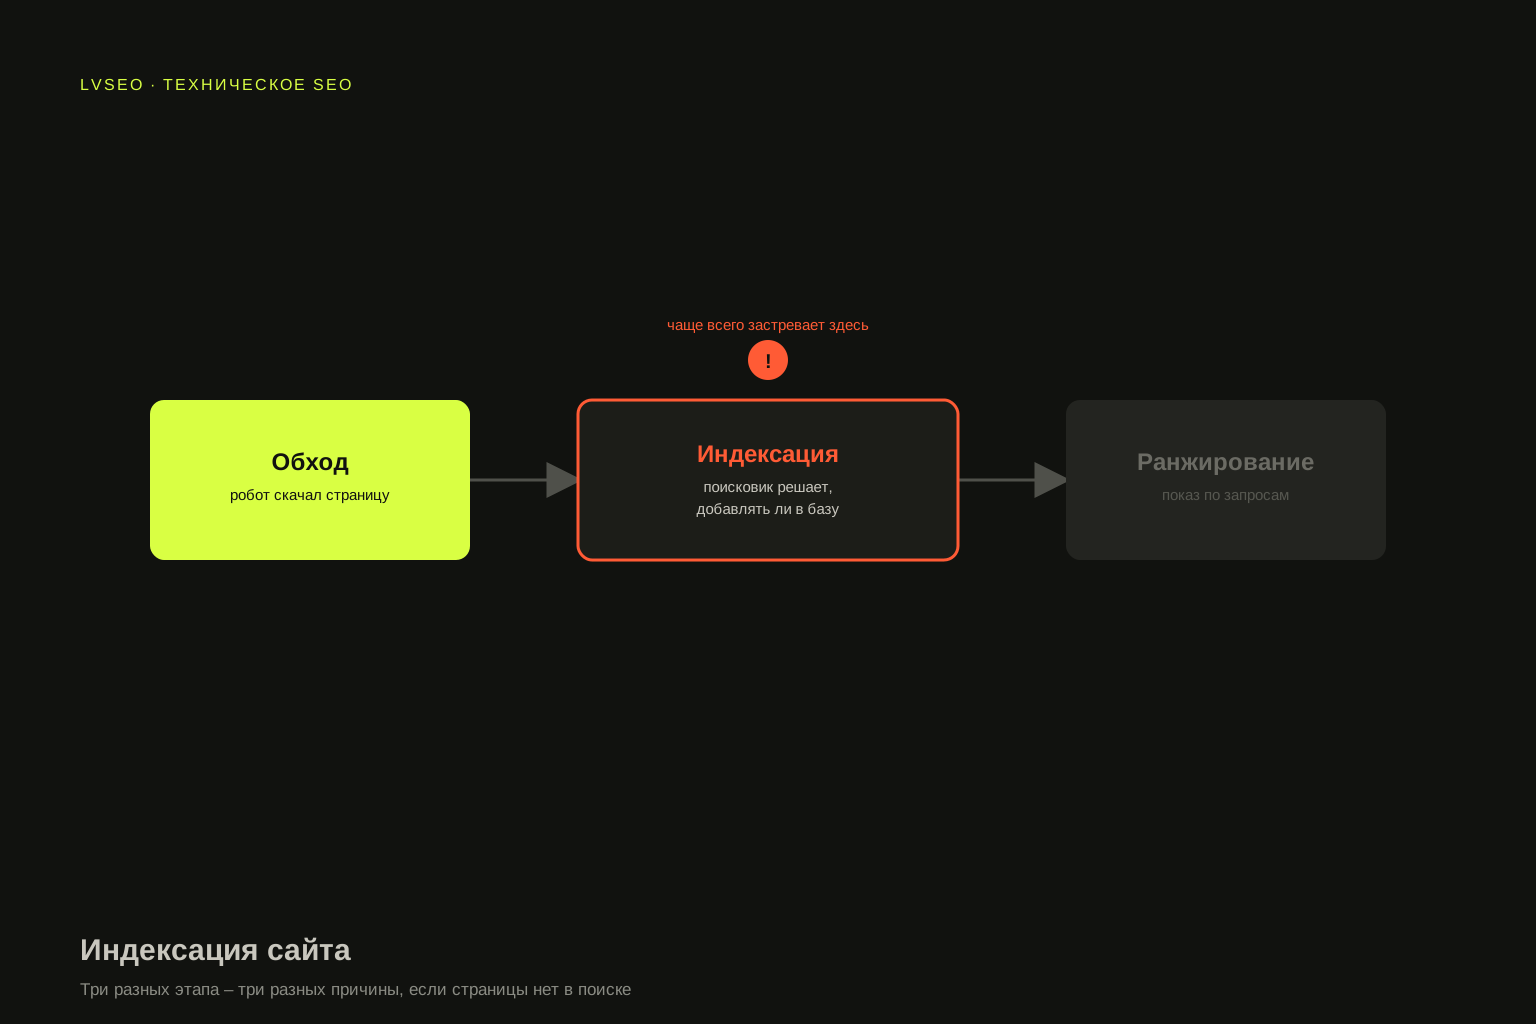
Три этапа, которые обычно путают
Первый этап – обход, или краулинг: робот заходит по ссылке или из карты сайта и скачивает содержимое страницы. Второй – индексация: поисковик решает, добавлять ли эту страницу в свою базу и в каком виде. Третий – ранжирование: попадание в базу ничего не гарантирует, страница может лежать в ней и при этом не показываться ни по одному запросу в топ-100.
Ошибка почти всегда в том, что владелец сайта видит только результат – «страницы нет в поиске» – и сразу берется за действия, которые лечат не тот этап. Ускорять обход бесполезно, если страница закрыта в robots.txt: робот физически не может ее просканировать, сколько запросов на переобход ни отправляй. Просить переобход бессмысленно, если дело в контенте: страница обойдена исправно, но поисковик считает ее дублем или недостаточно полезной, чтобы держать в базе.
Поэтому первый шаг – не чинить наугад, а определить, на каком именно этапе застряла страница. Дальше это делается по отчетам, а не по догадкам.
Как за пять минут проверить, на каком этапе застряла страница
Быстрая, но грубая проверка – оператор site: с точным адресом страницы. Если он ничего не находит, страница либо не обойдена, либо исключена из индекса; но оператор не говорит, почему, и иногда ошибается на разово обновленных страницах.
Точный ответ дают панели вебмастеров. В Google Search Console инструмент проверки URL сверху панели показывает статус «Страница есть в Google» или «Страница не проиндексирована» с конкретной причиной: не найдена, заблокирована в robots.txt, помечена как noindex, дубль без выбранной канонической версии и так далее. В Яндекс Вебмастере в разделе «Индексирование» → «Страницы в поиске» есть вкладка исключенных страниц с похожей классификацией: запрещено к индексированию, дубль, некачественная и другие категории.
Разница в том, что Google показывает состояние на момент последнего обхода, а Яндекс группирует страницы по устойчивым категориям накопленной статистики. Для диагностики нужны обе панели: они смотрят на одну и ту же страницу под разными углами и иногда называют разные причины для внешне одинаковой проблемы.
site:ваш-сайт.ru/adres-stranicy

# Google Search Console: Проверка URL (строка вверху) -> вставить адрес
# Яндекс Вебмастер: Индексирование -> Страницы в поиске -> Исключенные страницыРобот не может попасть на страницу
Это самая грубая и при этом самая частая группа причин: страница физически недоступна роботу или демонстративно закрыта от поиска. Такие случаи разгребаются быстрее всего, но именно их чаще всего пропускают, потому что для живого посетителя страница открывается нормально.
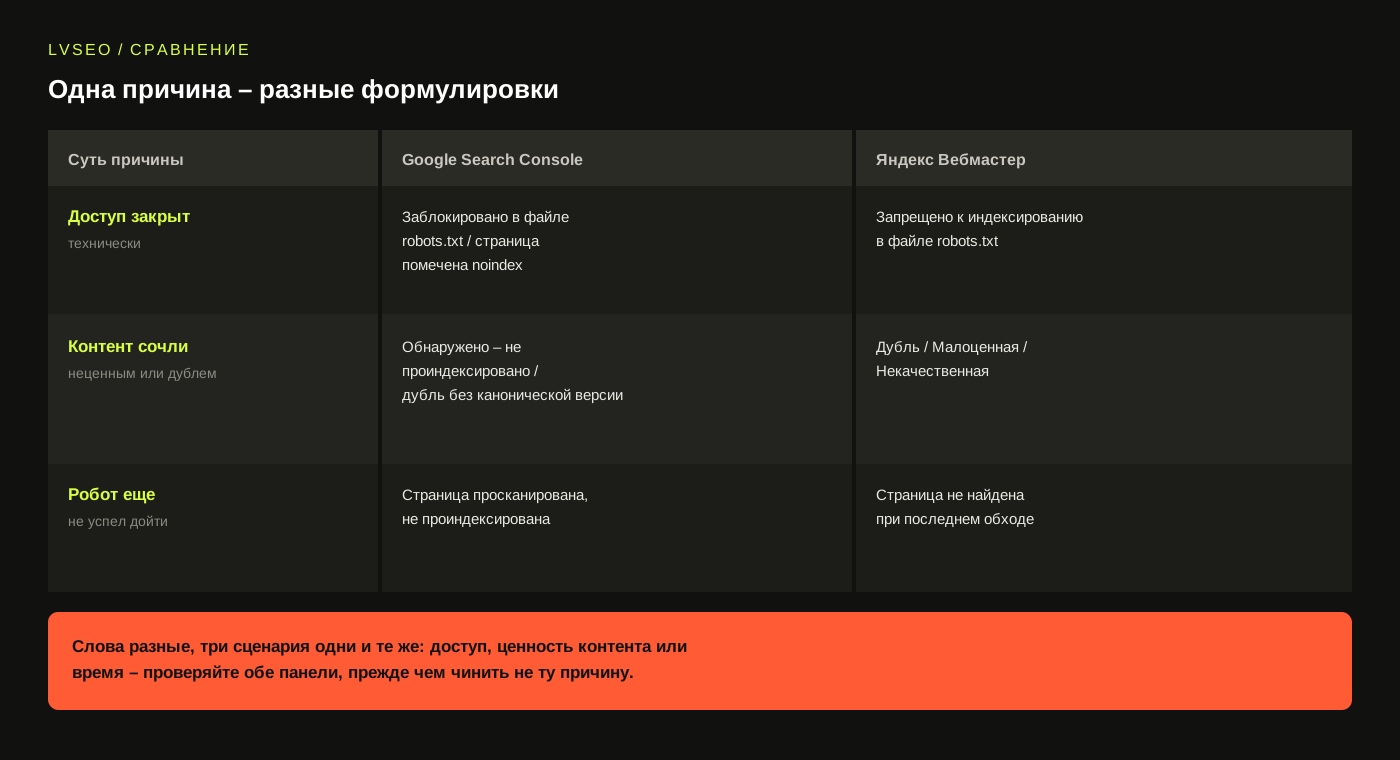
Правило Disallow в robots.txt блокирует не только конкретный адрес, но и весь раздел, если правило написано неточно: одна лишняя строка после переезда на новый движок способна закрыть от обхода тысячи страниц сразу. Тег noindex в HTML или заголовок X-Robots-Tag: noindex в ответе сервера работают иначе: робот приходит на страницу и честно ее читает, но не добавляет в базу поиска, потому что ему явно сказали этого не делать – такой тег иногда остается после переноса сайта с тестового поддомена, где noindex стоял оправданно.
- Disallow в robots.txt закрывает раздел или всю страницу от обхода – частая причина, которую находят уже после публикации
- тег noindex в HTML или заголовок X-Robots-Tag: noindex в ответе сервера – робот приходит, но не берет страницу в поиск по прямому указанию
- код ответа 403, 404 или 5xx вместо 200 – с точки зрения робота такой страницы не существует
- страница требует авторизации или скрыта до согласия с куки-баннером, который блокирует основной контент
- критичный текст подгружается через JavaScript и не виден в исходном HTML-ответе сервера
- длинная цепочка редиректов – робот останавливает переходы после нескольких прыжков и не доходит до конечного адреса
Часть этих причин – коды ответа, скорость и доступность в момент обхода – связаны не с самим сайтом, а с хостингом и его настройками; проверка стоит того, чтобы исключить эту причину в первую очередь.
Страница технически доступна, но не нужна поиску
Вторая группа причин сложнее первой: робот заходит на страницу без ошибок, но поисковик сознательно не держит ее в базе. Google в таких случаях обычно пишет «Дубль, канонический URL не выбран пользователем» или «Обнаружено – не проиндексировано» – это означает, что содержимое сочли недостаточно ценным по сравнению с уже размещенными в поиске страницами. Яндекс использует категории «Дубль», «Малоценная» и «Некачественная»: формулировки жестче, но суть та же.
Типичные источники такой проблемы – тонкий контент, который почти не отличается от десятков похожих страниц каталога, canonical, случайно указывающий на чужой или неактуальный адрес, и внутренняя конкуренция, когда две страницы сайта отвечают на один и тот же запрос. Последнее – отдельная и очень частая причина, у нее свои признаки и своя диагностика.
Если по отчетам видно, что две страницы конкурируют за один и тот же запрос, это отдельная проблема – каннибализация запросов – и лечится она объединением или разведением страниц по интенту, а не переобходом.
Бюджет обхода: когда проблема не в одной странице, а в тысячах
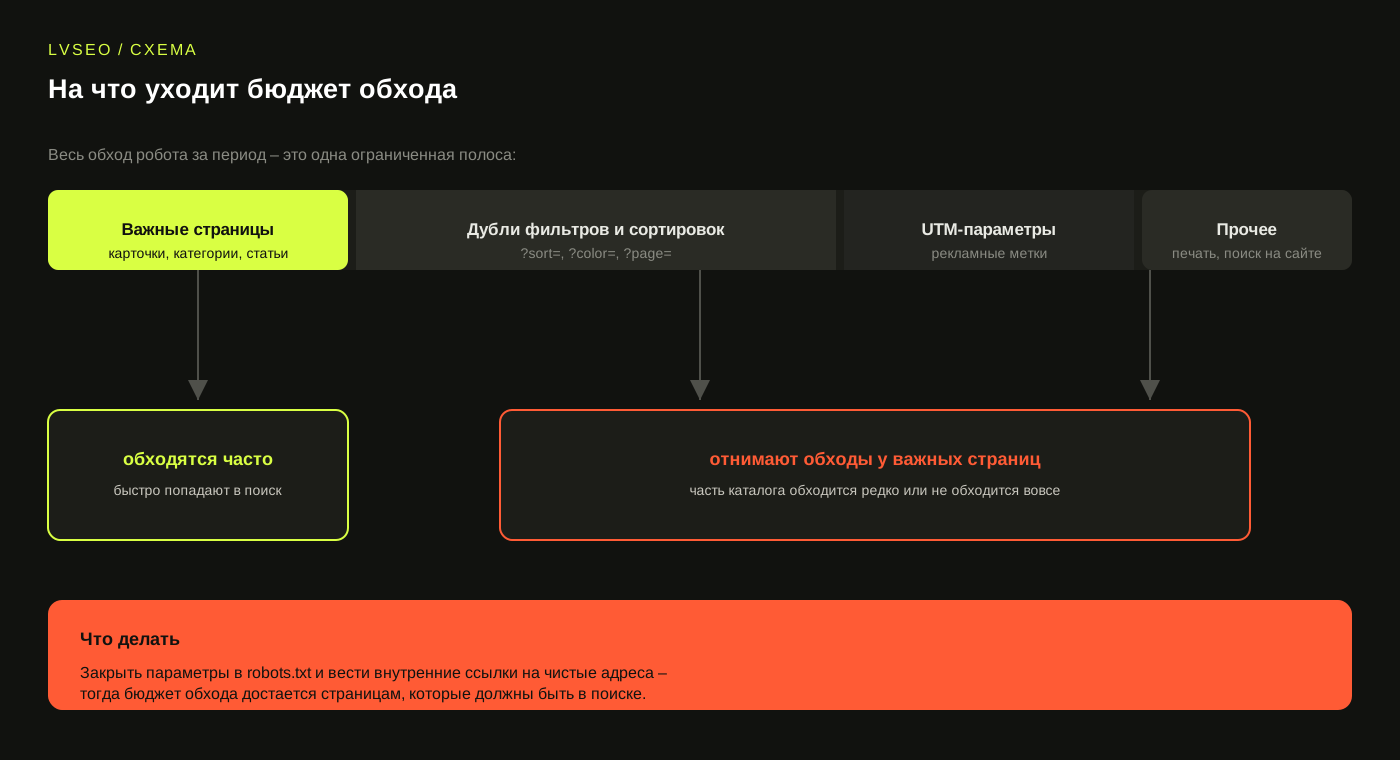
На небольшом сайте из полусотни страниц робот успевает обойти все за один заход, и вопрос бюджета обхода почти не встает. На каталоге из десятков тысяч карточек товаров ситуация другая: у робота есть ограниченный лимит запросов к сайту за период, и он тратится не только на нужные страницы, но и на дубли фильтров, страницы с UTM-параметрами, версии для печати и бесконечную пагинацию.
В результате часть каталога обходится редко или не обходится вовсе – не потому, что эти страницы плохие, а потому что робот физически не успевает до них дойти при текущей структуре ссылок и параметров. Проверяется это по логам сервера и по отчету о статистике сканирования: если число обойденных страниц в день намного меньше общего числа страниц сайта, а важные разделы обновляются в поиске с задержкой в недели, дело в бюджете обхода.
Внутренняя перелинковка – самый доступный рычаг здесь: страницы, на которые ведет мало внутренних ссылок или ведет только пагинация, робот считает менее важными и обходит их в последнюю очередь.
Как выстроить ссылки так, чтобы вес и внимание робота доставались нужным страницам, а не случайным адресам, разбираю в статье о внутренней перелинковке сайта .
Причины исключения бок о бок: Яндекс Вебмастер и Google Search Console
Формулировки причин в двух панелях не совпадают дословно, но по смыслу почти всегда сводятся к одним и тем же трем сценариям: доступ закрыт технически, контент сочли неценным или дублирующим, страница просто еще не обойдена. Ниже – как читать одну и ту же проблему в терминах обеих систем, чтобы не тратить время на поиск несуществующей разницы.
Не проиндексировано – еще не значит выпало из выдачи навсегда. У новых страниц и у крупных сайтов задержка в обходе – это нормальный процесс, а не ошибка; тревожиться стоит, если статус не меняется неделями после устранения технической причины.
Как ускорить индексацию, когда причина устранена
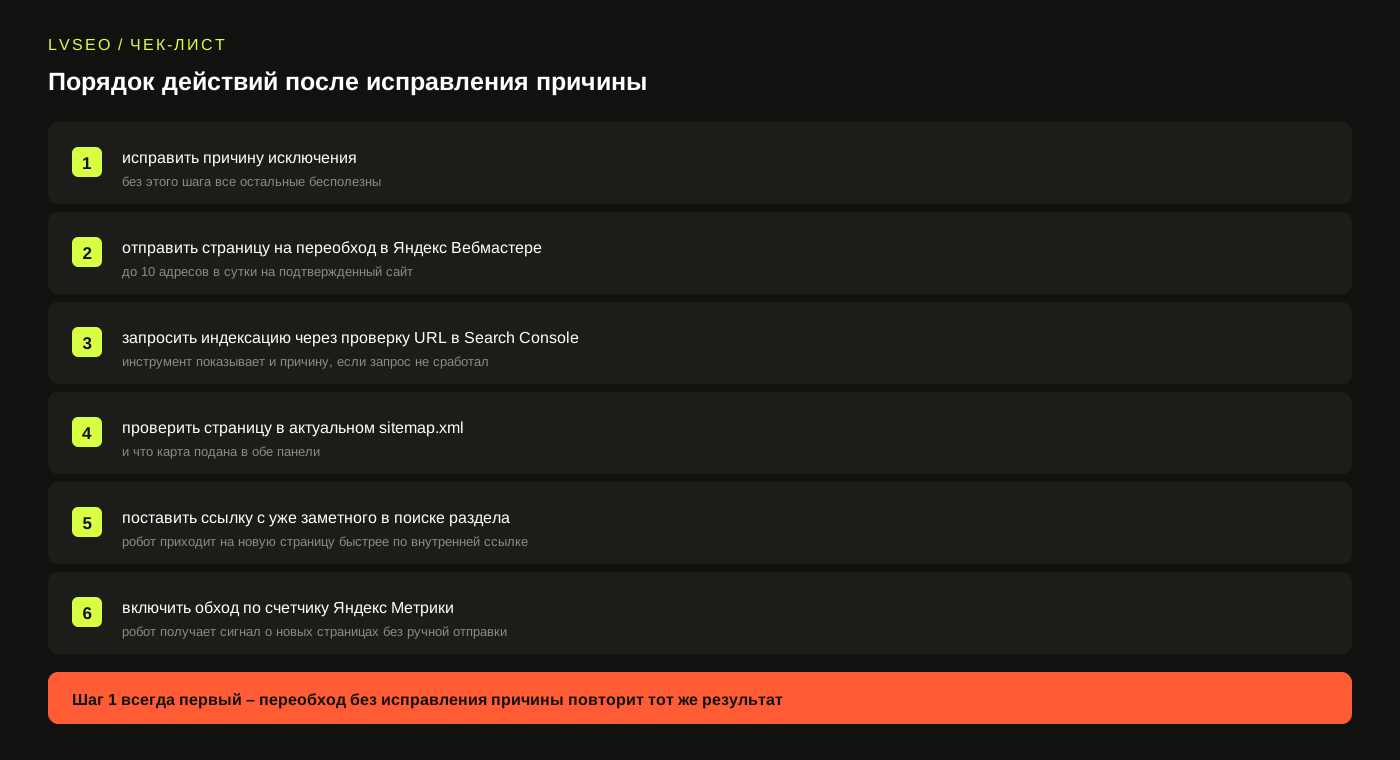
Ускорять индексацию до устранения причины бессмысленно: запрос на переобход заблокированной или помеченной noindex страницы просто повторит тот же результат. Как только причина найдена и исправлена, следующие шаги действительно сокращают время ожидания.
В Яндекс Вебмастере инструмент «Переобход страниц» принимает до 10 адресов в сутки на подтвержденный сайт, и по опыту страница обычно возвращается в поиск в течение одной-двух недель после подтвержденного исправления. Если на сайте подключен счетчик Яндекс Метрики, в его настройках можно включить обход по счетчику – робот получает сигнал о новых и обновленных страницах через саму Метрику и заходит на них быстрее, без ручной отправки адресов.
- исправить причину – без этого шага запрос на переобход не поможет
- отправить страницу через «Переобход страниц» в Яндекс Вебмастере – до 10 адресов в сутки
- запросить индексацию через инструмент проверки URL в Google Search Console
- проверить, что страница есть в актуальном sitemap.xml и он подан в обе панели
- поставить внутреннюю ссылку на страницу с уже заметного в поиске и часто посещаемого раздела
- включить обход по счетчику Яндекс Метрики, если он еще не подключен
Пример из практики и что делать, если ничего не помогает
На одном интернет-магазине с каталогом около 40 000 карточек товаров в Google Search Console было проиндексировано только 61% страниц, а остальные числились как «Обнаружено – не проиндексировано». Логи сервера показали, что робот действительно заходил на многие из этих карточек, но редко возвращался повторно. Причина оказалась в фильтрах каталога: почти на каждую карточку вело по 15-20 внутренних ссылок с URL-параметрами сортировки и фильтров, и робот тратил обход на эти варианты вместо основного адреса.
Мы закрыли параметрические адреса в robots.txt, расставили canonical на чистый URL карточки и добавили прямые ссылки на карточки из карточек товара той же категории, минуя параметры. Через семь недель доля карточек в поиске выросла до 89%, а органический трафик по категориям с ранее плохо видимыми в поиске товарами увеличился на 34%.
Если после исправления технической причины страница все равно не возвращается в индекс несколько недель, обычно дело в одном из трех: сервер отдает роботу и обычному браузеру разное содержимое (проверяется инструментом просмотра как Googlebot), на сайте есть противоречащие друг другу сигналы – например, canonical указывает на страницу A, а внутренние ссылки и sitemap настойчиво продвигают страницу B, – или контент страницы объективно уступает конкурентам в выдаче по тому же запросу. Первые два случая – техническая проверка, третий требует уже не индексации, а доработки содержания.
Такие проблемы редко ограничиваются одной страницей и обычно всплывают при полной SEO-диагностике сайта – она проверяет видимость сайта в поиске наравне со скоростью, структурой и техническими ошибками.