Что считать дублем и чем он опасен
Дубль – это не только скопированный вручную текст. В большинстве случаев на сайте нет ни одной страницы, которую кто-то специально скопировал: дубли создает сама система адресов. Товар открывается по прямому адресу и по адресу внутри категории, одна и та же страница одновременно работает с www и без, со слэшем на конце и без него, по http и по https. Содержимое одинаковое, а адресов – несколько.
Разница между полным и частичным дублем важна для выбора решения. Полный дубль – это байт в байт одна и та же страница по двум адресам: здесь спорить не о чем, остается один адрес. Частичный, или неполный дубль – когда страницы совпадают в основном, но отличаются деталями: карточка одного товара в разных city-версиях каталога, страница фильтра, где меняется только заголовок над тем же списком товаров. С частичными дублями решение принимается по каждому случаю отдельно: иногда достаточно canonical, а иногда странице нужен собственный уникальный контент, а не просто склейка адресов.
Вред от дублей не в фильтре или санкции – обычно до них дело не доходит. Он практичнее: поисковик распределяет вес ссылок и поведенческие сигналы между несколькими адресами вместо одного, и из-за этого ни один не набирает полную силу. Робот тратит ограниченный бюджет обхода на копии, и до части действительно новых страниц он попросту не доходит. А в выдаче может показываться то один адрес дубля, то другой – позиции будто прыгают без видимой причины, хотя по сумме кликов страница работает стабильно.
- в Вебмастере растет категория «Дубли» или число исключенных страниц
- в выдаче по одному и тому же запросу то и дело меняется показанный адрес страницы
- в Search Console есть статус «Дубль, канонический URL не выбран пользователем»
- число проиндексированных страниц заметно больше числа реальных страниц сайта
Технические дубли и бюджет обхода
Самая частая причина дублей – не контент, а настройки сервера и движка. Один и тот же адрес одновременно откликается в нескольких вариантах, и ни один из них не ведет редиректом на другой.
- с www и без www
- по http и по https одновременно
- со слэшем на конце адреса и без него
- с заглавными буквами в адресе и со строчными
- главная страница дополнительно открывается по /index.php или /home
- адрес с UTM-меткой или идентификатором сессии индексируется как отдельная страница
- версия для печати существует отдельным адресом без canonical на основную страницу
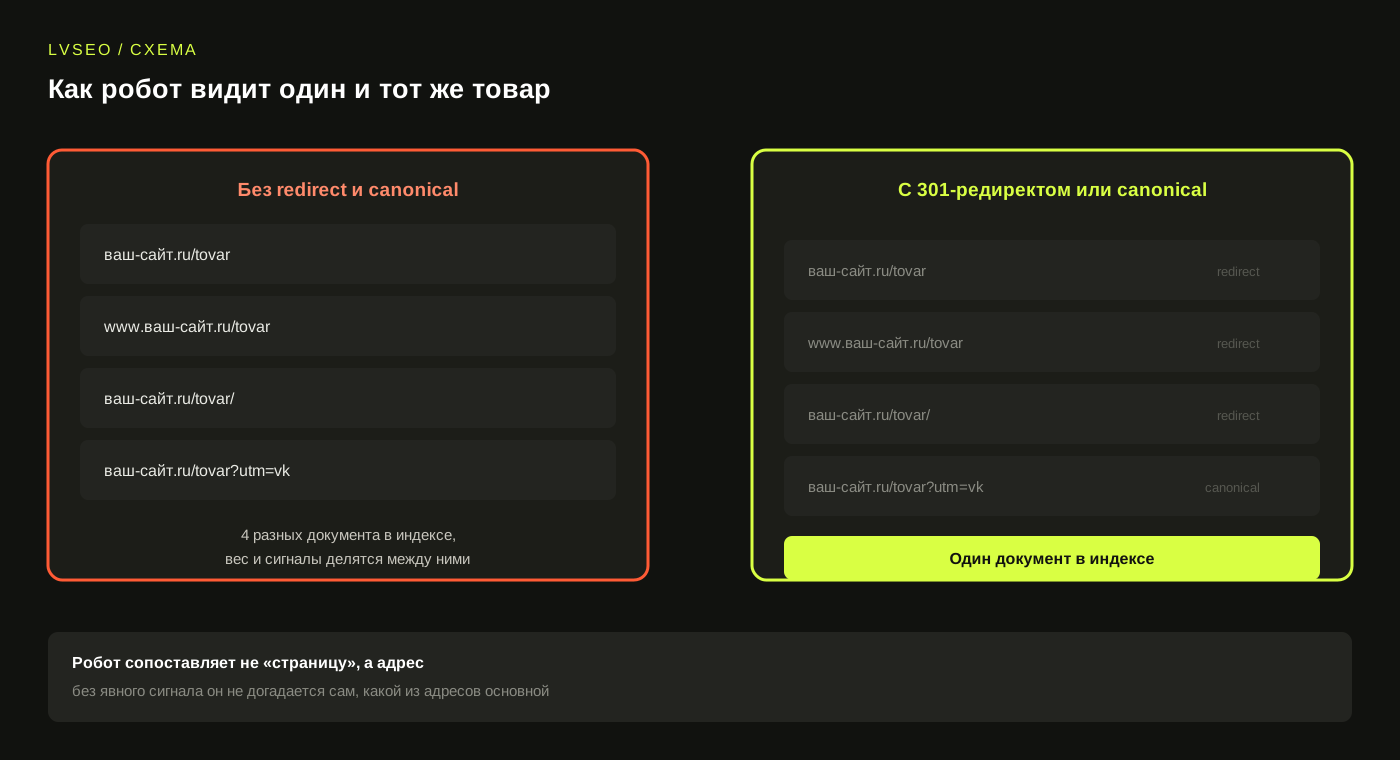
Каждый такой вариант – лишний адрес, который робот тоже обходит, хотя содержимого там ровно столько же, сколько на основном; на каталоге из нескольких тысяч карточек лишние обходы съедают заметную долю бюджета обхода. Как читать отчеты об обходе и почему часть каталога не попадает в индекс из-за исчерпанного лимита, я подробно разбирала в статье про индексацию сайта ; дубли – одна из главных причин, почему этот лимит расходуется впустую.
Дубли каталога: фильтры, сортировки и пагинация
У интернет-магазина технические дубли часто перерастают в дубли по существу: фильтр по цвету, сортировка по цене, переключение вида списка – каждый параметр в адресе создает страницу, которая показывает тот же набор товаров, что и без параметра, просто в другом порядке или с сужением.
Проблема не в самих фильтрах, а в том, что почти всегда их делают индексируемыми по умолчанию: комбинаций цвет плюс размер плюс бренд на каталоге из пары тысяч товаров может получиться в разы больше, чем самих товаров. Индексировать стоит только те комбинации, на которые есть отдельный поисковый спрос – это проверяется по частотности в Яндекс Вордстат или Планировщике ключевых слов, а не назначается на глаз. Остальные варианты либо закрываются от индексации, либо получают canonical на страницу категории.
Отдельно стоит пагинация. Долгое время вторые и следующие страницы листинга закрывали noindex-ом, но это отрезает от индекса заодно и товары, на которые они ведут. Более безопасный вариант – self-referencing canonical: у каждой страницы листинга canonical указывает сама на себя, а не на первую страницу, тогда все товары остаются доступны роботу через обычную перелинковку.
Как развести полезные фильтры и технический мусор без потери позиций у каталога с тысячами карточек, я разбираю в рамках SEO-продвижения интернет-магазина – вместе с распределением запросов по страницам.
Как найти дубли у себя: отчеты и инструменты
Проверка начинается с того, что уже посчитали за вас поисковики. В Яндекс Вебмастере это раздел «Индексирование» → «Страницы в поиске», вкладка «Исключенные»: там есть отдельная категория «Дубли» со списком конкретных адресов и указанием, на какую страницу они дублируют. В Google Search Console это отчет «Страницы», группы «Дубль, канонический URL не выбран пользователем» и «Google выбрал другую каноническую страницу, чем указано пользователем» – вторая опаснее, потому что означает, что ваш canonical поисковик просто проигнорировал.
Дальше – ручная проверка. Поиск по фрагменту уникального текста страницы быстро показывает, сколько раз он проиндексирован. Полное сканирование сайта краулером вроде Screaming Frog и сортировка результата по Title, H1 или Description сразу показывает страницы с одинаковыми значениями – это и есть кандидаты в дубли, даже если формально адреса выглядят разными.
- выгрузить список «Дубли» из Вебмастера и «Страницы» из Search Console
- просканировать сайт краулером и отсортировать результат по Title и Description
- проверить, отдает ли сайт одну и ту же страницу с www и без, по http и по https
- проверить canonical у страниц с параметрами и пагинацией в исходном коде, а не только визуально
Такую проверку я провожу полностью, вместе с остальной технической частью, в рамках SEO-аудита сайта – отчеты поисковиков дают только часть картины, остальное видно по логам и сканированию.
Три способа устранения: 301, canonical или noindex
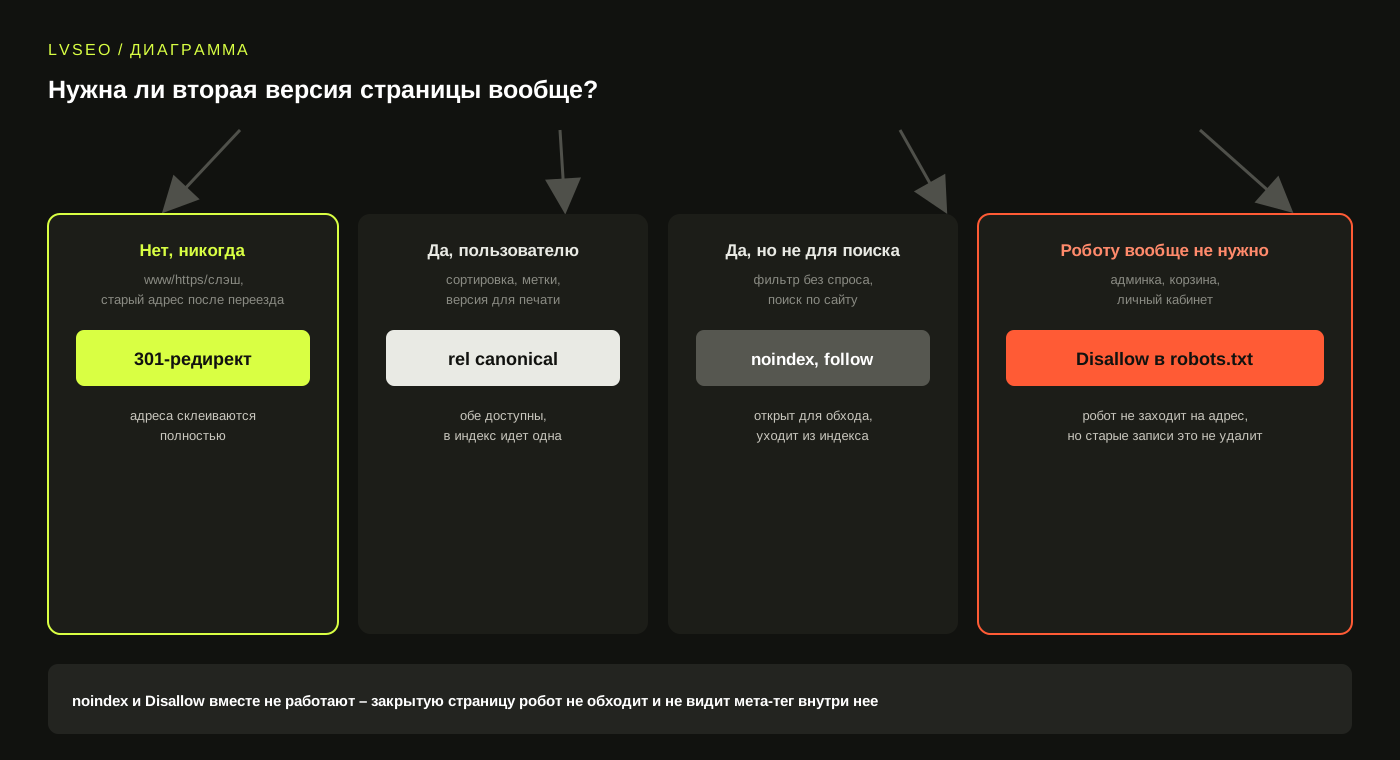
У каждого способа устранения дублей своя задача, и путать их – частая ошибка. Разница не в «силе» инструмента, а в том, нужна ли вторая версия страницы пользователю вообще.
Самая частая ошибка на практике – закрыть страницу в robots.txt и одновременно поставить на нее noindex, надеясь усилить эффект. Получается наоборот: раз робот не может обойти страницу, он не видит мета-тег noindex внутри нее и иногда годами продолжает держать голый адрес в выдаче без описания. Если нужно гарантированно убрать страницу из индекса, открывайте ее для обхода и закрывайте только noindex-ом, а Disallow оставляйте для разделов, которые не нужны роботу вообще ни в каком виде.
| Способ | Когда использовать | Что происходит |
|---|---|---|
| 301-редирект | Вторая версия не нужна никому и никогда – www/https/слэш, старый адрес после переезда | Адреса склеиваются полностью, вес и трафик переходят на основной URL |
| rel canonical | Обе версии остаются нужны – сортировка, метки, версия для печати, страница пагинации | Обе страницы открываются, но в индекс и выдачу поисковик берет только каноническую |
| noindex, но открыт для обхода | Страница нужна для навигации по сайту, но не для поиска – фильтр без своего спроса, поиск по сайту | Страница уходит из индекса, а ссылки с нее по-прежнему обходятся и передают вес дальше |
| Disallow в robots.txt | Раздел вообще не должен попадать к роботу – админка, корзина, личный кабинет | Робот перестает заходить на адрес, но уже проиндексированные ранее страницы это не удаляет |
Пример из практики: интернет-магазин сантехники
У одного из клиентов – интернет-магазина сантехники – в Вебмастере скопилось несколько тысяч строк в категории «Дубли» уже к моменту первого аудита. У каждой карточки товара было по три-четыре рабочих адреса: с завершающим слэшем и без, с параметром сортировки внутри категории и отдельная версия для печати без единого мета-тега. Внешне сайт выглядел нормально, посетитель разницы не замечал.
Правки были обычными, без ничего экзотического: 301 на канонический адрес без слэша, canonical на страницы с сортировкой и запрет версий для печати в robots.txt, потому что для них не было и не могло быть отдельного спроса. За две-три недели после правок число строк в «Дублях» пошло вниз, а обход робота стал доходить до карточек, которые раньше обновлялись в поиске с задержкой в несколько недель.
Дубли были не единственной технической причиной в этом проекте – остальная работа с доступностью страниц, распределением запросов и содержанием каталога растянулась на полтора года.
Похожую техническую работу с дублями каталога я вела в кейсе SEO интернет-магазина сантехники – там устранение дублей и склейка адресов стали одним из первых шагов технической части.
Дубли и каннибализация запросов – разные проблемы
Дубли и каннибализацию запросов путают потому, что симптом похож: в выдаче по одному запросу то и дело показывается то одна страница сайта, то другая. Но причина и лечение у этих проблем противоположные.
Дубль – это одна и та же страница по двум и более адресам: контент идентичен или почти идентичен, решение – оставить один адрес любым из трех способов выше. Каннибализация – наоборот, это разные страницы с разным содержанием, которые отвечают на один и тот же запрос: решение здесь не склеить адреса, а развести страницы по разным намерениям пользователя или объединить их в одну, переписав контент, а не просто указав canonical.
Проверка простая: откройте обе страницы рядом. Если текст совпадает на 80-90% – это дубль, чините адресацией. Если текст разный, а запрос один – это каннибализация, и здесь нужна отдельная диагностика.
Как найти конкурирующие страницы и выбрать одну из четырех стратегий их разведения, я подробно разбирала в статье про каннибализацию запросов ; путать эти две проблемы – значит лечить симптом вместо причины.
Как спроектировать структуру URL, чтобы дублей не возникало
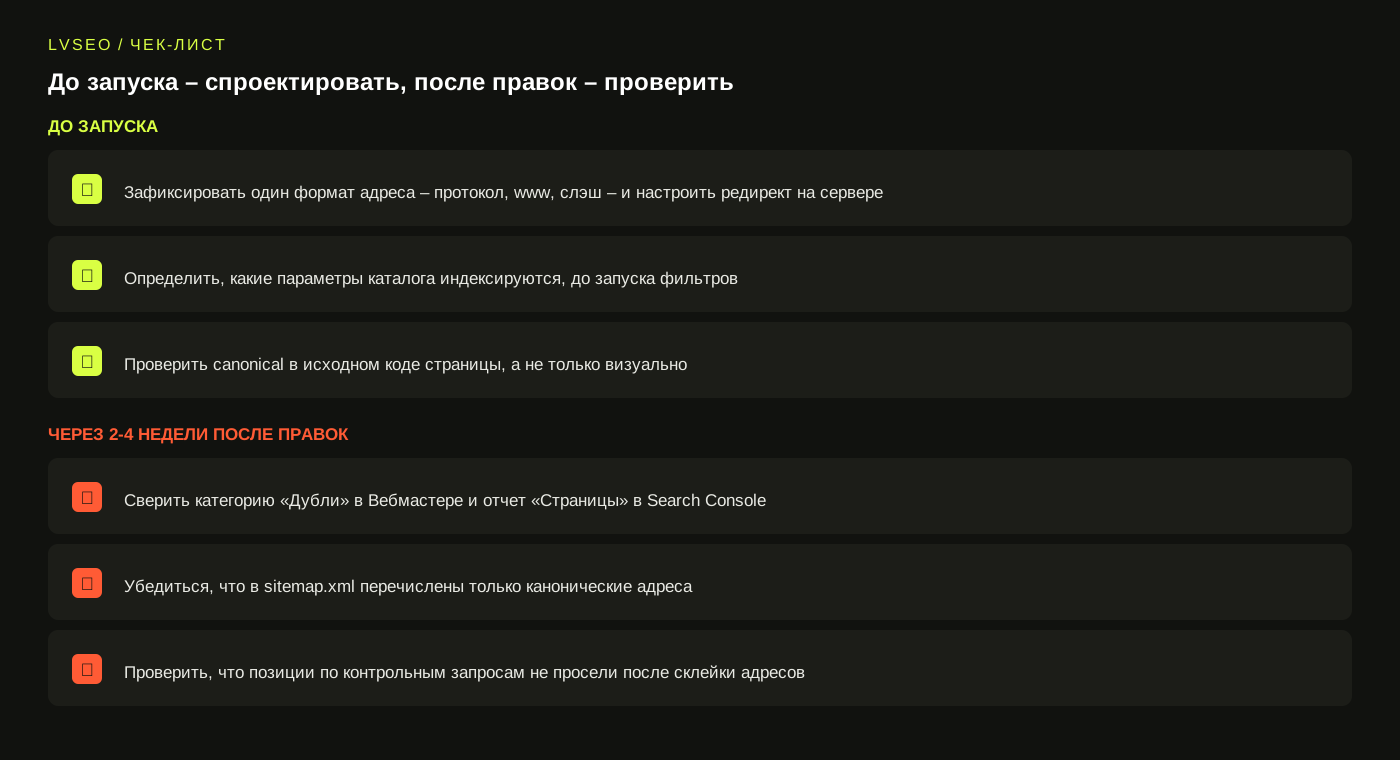
Дешевле не чинить дубли, а не создавать их вовсе. Три решения принимаются один раз, на старте сайта или каталога, и потом почти не требуют внимания: единый формат адреса – протокол, www, слэш – зафиксировать и настроить редиректом на уровне сервера, а не понадеяться на память; список параметров, которые вообще не должны индексироваться; и правило для новых разделов – у каждой сущности один способ попасть в структуру сайта, а не два-три одновременно доступных пути.
На практике это решается на этапе проектирования структуры, а не постфактум на живом сайте с историей в индексе: тогда же закладывается, какие фильтры получат отдельные страницы с самостоятельным спросом, а какие останутся техническими параметрами без индексации.
- зафиксировать один формат адреса – протокол, www, слэш – и настроить редирект на уровне сервера
- определить, какие параметры каталога индексируются, а какие блокируются, до запуска фильтров
- проверить canonical в исходном коде страницы, а не только визуально
- через 2-4 недели после правок сверить категорию «Дубли» в Вебмастере и отчет «Страницы» в Search Console
- убедиться, что в sitemap.xml перечислены только канонические адреса
- проверить, что позиции по контрольным запросам не просели после склейки адресов
Такое распределение фильтров, категорий и параметров закладывается один раз, на этапе SEO-проектирования сайта – переделывать структуру каталога на работающем сайте дороже и дольше.