Почему JavaScript ломает индексацию, если его не готовить
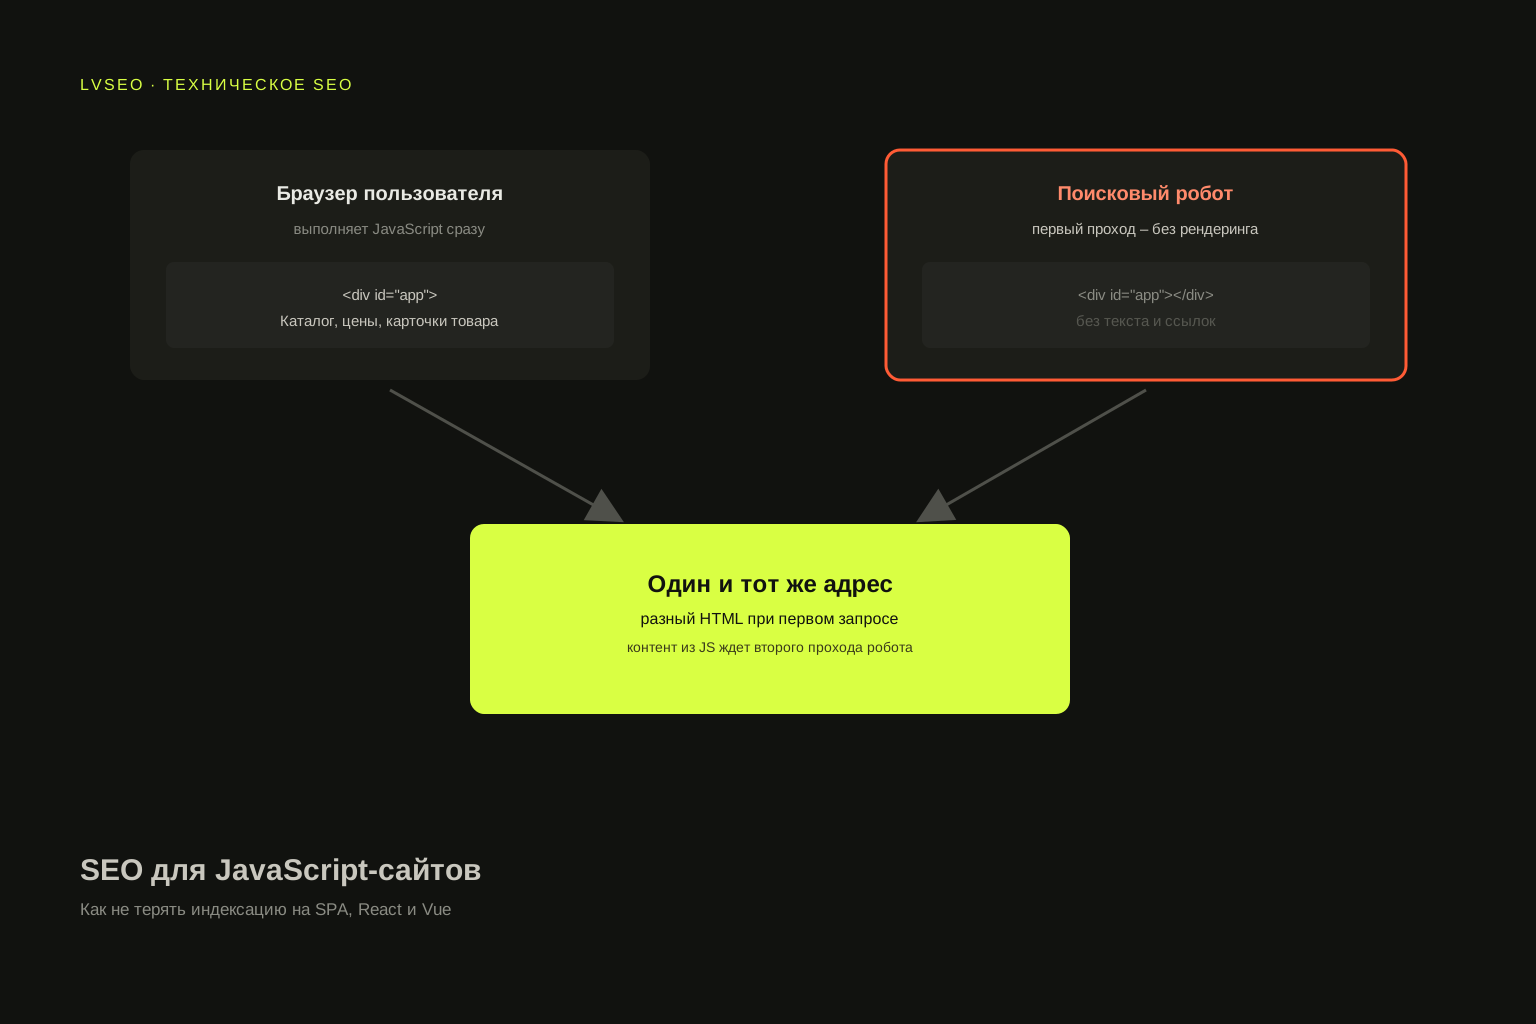
Поисковый робот – не браузер посетителя. Сначала он получает исходный HTML-документ, который отдает сервер, и только потом, отдельным и не всегда быстрым проходом, выполняет код, чтобы увидеть то, что страница показывает живому человеку. Если между этими двумя моментами нужный текст не появляется в документе, робот может решить, что страница пустая, отложить ее рендеринг на потом или вовсе не включить в индекс.
У клиентов, переехавших на React, Vue или Angular без серверного рендеринга, картина обычно похожая: обновления, которые раньше попадали в выдачу за два-три дня, начинают проявляться через две-четыре недели, а часть карточек каталога зависает в отчете Google Search Console со статусом «обнаружена, не индексируется».
Это не повод отказываться от современного стека. Это повод развести две разные задачи: быстрый и удобный интерфейс для человека – забота фронтенда, предсказуемый и своевременный HTML для робота – забота SEO. Дальше по порядку о том, как устроена эта вторая задача и что в ней чаще всего идет не так.
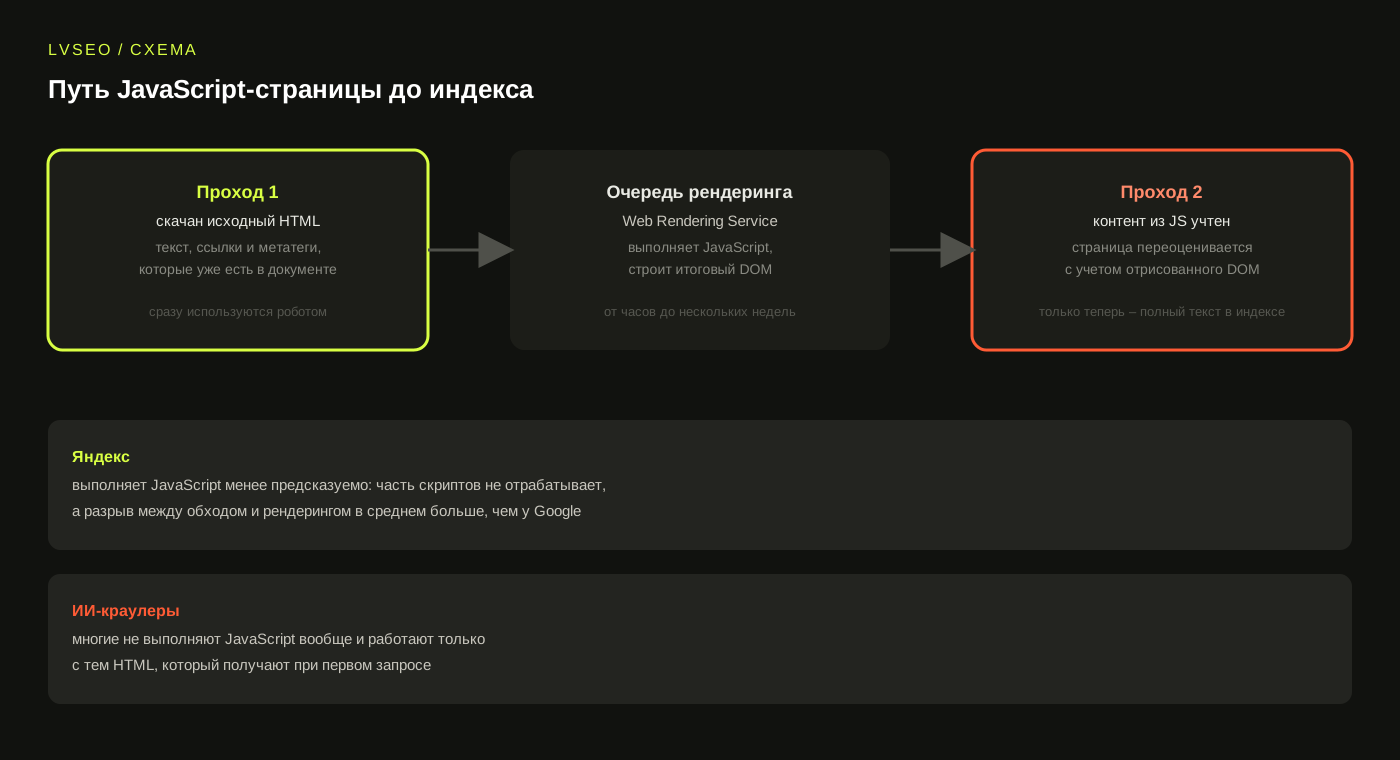
Ставки выросли еще сильнее с появлением краулеров генеративного поиска и ИИ-ассистентов: многие из них не выполняют JavaScript вообще и работают только с тем HTML, который получают при первом запросе. Сайт, который рассчитывает не только на классическую выдачу, но и на упоминания в ответах нейросетей, не может позволить себе отдавать роботам пустой контейнер вместо текста.
Как Google и Яндекс на самом деле видят JavaScript
Google обрабатывает JavaScript в два прохода. Сначала Googlebot скачивает исходный HTML и сразу использует то, что там есть: текст, ссылки, метатеги. Затем страница становится в очередь на рендеринг, где Web Rendering Service – специальная версия Chromium – выполняет скрипты и строит итоговый DOM. Контент, появившийся благодаря JavaScript, попадает в индекс только после этого второго прохода.
Разрыв между проходами не фиксирован. Google не называет точные сроки, но на технически здоровых сайтах с достаточным бюджетом сканирования он обычно занимает от нескольких часов до нескольких дней; на новых доменах или перегруженных сайтах – растягивается на недели.
Яндекс официально поддерживает выполнение JavaScript, но ведет себя заметно менее предсказуемо: часть скриптов выполняется, часть – нет, а задержка между обходом и рендерингом на моих проектах была ощутимо больше, чем у Google. Поэтому для трафика из Яндекса серверный рендеринг – не опциональная оптимизация, а практически обязательное условие.
Раньше у Google был обходной вариант – динамический рендеринг, когда сервер отдавал обычным посетителям один HTML, а роботам по user-agent – заранее отрисованную версию. Google прямо называет этот прием временным костылем, а не решением: он усложняет поддержку сайта и создает риск случайно показать роботу не то, что видит человек. Сегодня это запасной вариант на время миграции, а не целевая архитектура.
CSR, SSR, SSG и гибридный рендеринг: что выбрать
У задачи рендеринга четыре типовых решения, и для SEO они не равноценны. Client-side rendering (CSR) отдает роботу почти пустой HTML и перекладывает всю отрисовку на браузер – самый дешевый вариант в разработке и самый рискованный для индексации. Server-side rendering (SSR) собирает готовую страницу на сервере при каждом запросе, поэтому и пользователь, и робот получают один и тот же заполненный HTML. Static site generation (SSG) готовит HTML заранее, на этапе сборки, и отлично подходит контенту, который меняется не каждый день. Гибридные схемы вроде инкрементальной статической регенерации сочетают готовый HTML с точечным обновлением отдельных страниц без пересборки всего сайта.
Выбор зависит от того, как часто меняется контент и сколько страниц нужно отдавать. Для блога и статей обычно достаточно SSG, для каталога с фильтрами и ценами – SSR или гибрид, а чистый CSR стоит оставлять только разделам, которые заведомо не нужны поиску: личному кабинету, корзине, внутренним дашбордам.
| Подход | Что получает робот при первом проходе | Когда уместен |
|---|---|---|
| CSR | Почти пустой HTML, контент только после выполнения JS | Закрытые от индексации разделы: кабинет, админка, корзина |
| SSR | Полностью готовый HTML на каждый запрос | Каталог, цены, страницы с часто меняющимися данными |
| SSG | Готовый HTML, собранный заранее на этапе сборки | Статьи, лендинги, страницы услуг с редкими правками |
| Гибрид (ISR) | Готовый HTML, который точечно обновляется без полной пересборки | Крупный сайт, где пересобирать все страницы разом слишком дорого |
Для интернет-магазина выбор особенно чувствителен: чистый CSR на страницах каталога и фильтров обычно требует отдельного разбора при продвижении интернет-магазина потому что именно эти страницы приносят основной коммерческий трафик.
Типичные ошибки SPA, которые режут позиции
Большинство проблем SEO на JavaScript-сайтах повторяется от проекта к проекту. Вот список, с которым я сверяю технический аудит SPA.
- один шаблон <title> и meta description на все маршруты – в выдаче все страницы выглядят одинаково
- переходы между страницами собраны на обработчике клика без настоящего атрибута href – робот не находит на странице ссылок на остальной сайт
- хеш-навигация вида «сайт.ru/#/catalog» вместо отдельных адресов – у разных разделов фактически один и тот же URL
- контент каталога подгружается только по кнопке «Показать еще» без постраничной навигации с собственными адресами – робот не доходит до второй и последующих страниц списка
- canonical генерируется в браузере и отсутствует в исходном HTML, который получает первый проход робота
- в sitemap.xml перечислены маршруты, которые рендер не успевает наполнить содержимым к моменту обхода
Хеш-навигация и общий URL для разных версий контента – частный случай более широкой проблемы, дублей страниц сайта которая мешает поиску понять, какой адрес считать основным.
Как проверить, что робот видит ваш контент
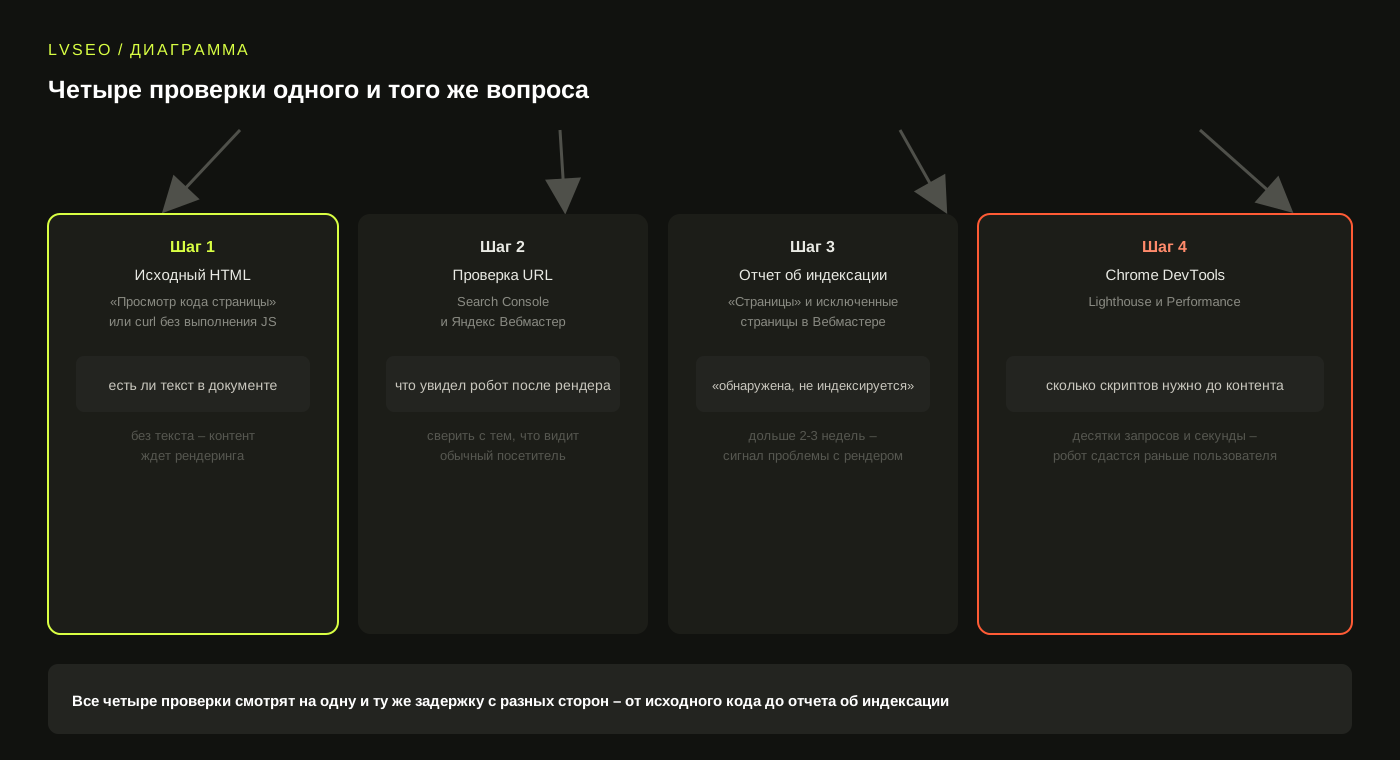
Первый шаг – посмотреть исходный HTML без выполнения JavaScript: «Просмотр кода страницы» в браузере (не «Инспектировать элемент», который показывает уже отрисованный DOM) или команда curl в терминале. Если нужного текста там нет, значит он появляется только после рендеринга, и вопрос только в том, сколько это займет времени.
Второй шаг – инструмент проверки URL в Google Search Console и аналогичная проверка в Яндекс Вебмастере. Оба показывают, что робот увидел уже после выполнения скриптов: сравните этот результат с тем, что видит обычный посетитель, и обратите внимание на расхождения в тексте, заголовках и ссылках.
Третий шаг – отчет «Страницы» в Search Console и раздел с исключенными страницами в Вебмастере. Статусы «обнаружена, но не индексируется» или «страница просканирована, но пока не в поиске», которые держатся дольше двух-трех недель, обычно означают проблему именно с рендерингом, а не с качеством контента.
Четвертый шаг – вкладка Lighthouse или панель Performance в Chrome DevTools: они показывают, сколько скриптов должно выполниться до появления основного контента и сколько реально занимает этот процесс. Если до текста нужно дождаться десятка запросов и нескольких секунд выполнения, у робота будет повод сдаться раньше, чем у терпеливого пользователя.
Когда расхождений много и непонятно, с какой страницы начинать разбор, технический SEO-аудит показывает все точки потери сразу, а не по одной за раз.
Чек-лист внедрения для разработчика и SEO-специалиста
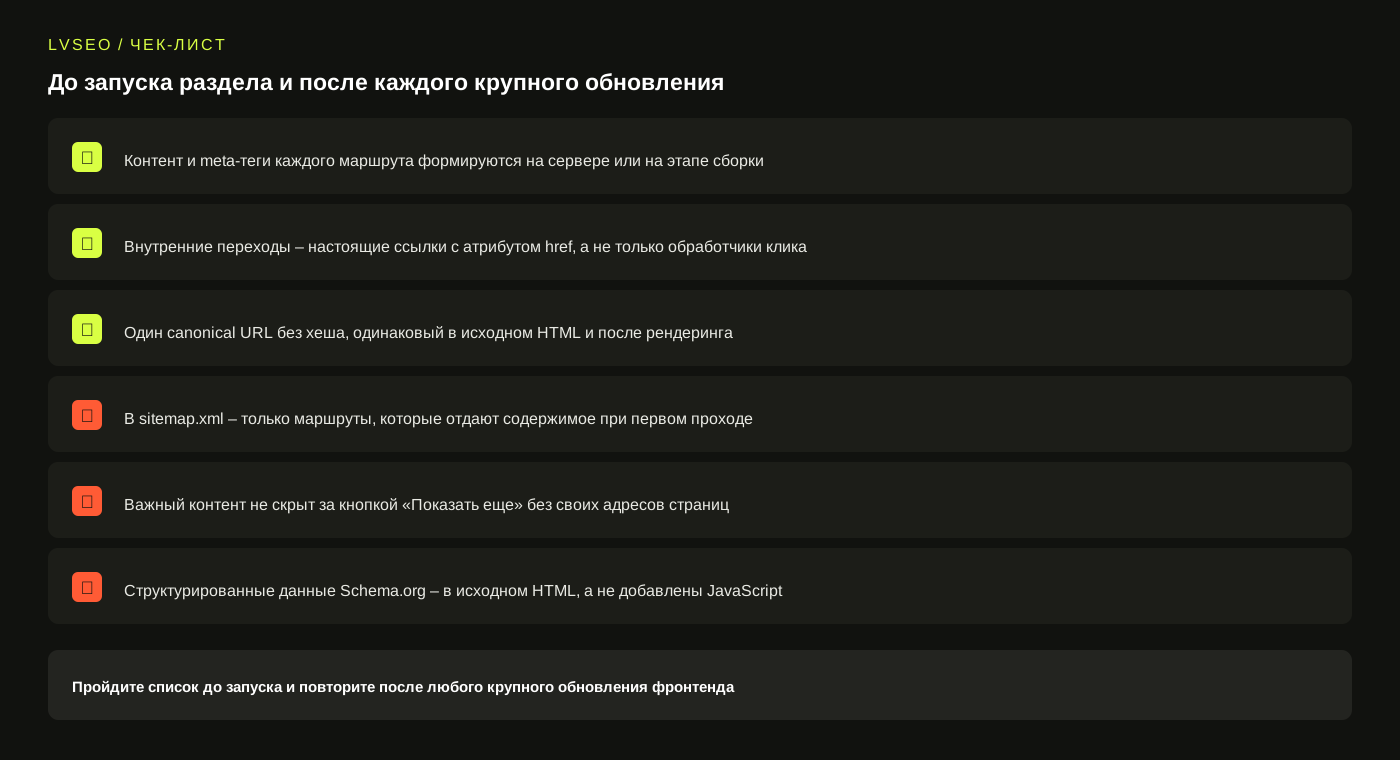
Этот список удобно пройти до запуска нового раздела на JavaScript и повторить после любого крупного обновления фронтенда.
- контент и meta-теги каждого маршрута формируются на сервере или на этапе сборки, а не только в браузере
- внутренние переходы – настоящие ссылки с атрибутом href, а не только обработчики клика
- у каждой страницы один canonical URL без хеша, одинаковый в исходном HTML и после рендеринга
- в sitemap.xml включены только маршруты, которые реально отдают содержимое при первом проходе робота
- критичный для SEO контент не скрыт за кнопкой «Показать еще» без постраничной навигации со своими адресами
- структурированные данные Schema.org присутствуют в исходном HTML, а не добавляются JavaScript после загрузки
Пример из практики: каталог с фильтрами на JavaScript
В одном из каталогов серверного оборудования фильтрация по брендам и характеристикам была реализована полностью на JavaScript: страницы фильтров собирались в браузере, а в исходном HTML, который получал робот, были только пустой контейнер и скрипты. Формально страницы существовали и были доступны пользователю, но для поиска большая часть из них оставалась невидимой месяцами.
После перехода на серверный рендеринг именно этих страниц – без переделки остального интерфейса – число проиндексированных страниц категорий выросло в течение следующих месяцев, а вместе с ним увеличился и трафик на страницы фильтров, которые раньше вообще не участвовали в выдаче. Важная деталь: менять пришлось не весь сайт, а только способ, которым отдавались конкретные страницы.
Отдельно пришлось проверить пагинацию внутри каждого фильтра: до правок вторая и третья страницы списка товаров открывались только кнопкой «Показать еще» без собственного адреса, поэтому робот физически не мог дойти до них через ссылки. Добавление отдельных URL для каждой страницы списка с сохранением текущего фильтра в адресе дало прирост не менее заметный, чем сам переход на серверный рендеринг.
Полный разбор этого и других проектов с похожими техническими задачами – в кейсе по каталогу серверного оборудования с динамикой трафика за весь период наблюдений.
Что в итоге
JavaScript не противопоказан SEO, но требует отдельного шага проверки, который легко пропустить, если тестировать сайт только в браузере. Главное правило простое: все, что должно попасть в индекс, должно быть видно в исходном HTML или появляться в рендере быстро и без лишних шагов – остальное можно смело оставлять на откуп клиентскому коду.
Начните с малого: откройте исходный код трех ключевых страниц без выполнения скриптов и сверьте их с отчетом об индексации. Если текста там нет – вы нашли первую точку, с которой стоит начинать.
Если за техническими правками не видно изменений в трафике и заявках, SEO-продвижение сайта связывает техническую основу с семантикой, контентом и аналитикой в одну работу.