Что делает robots.txt и чего он не делает
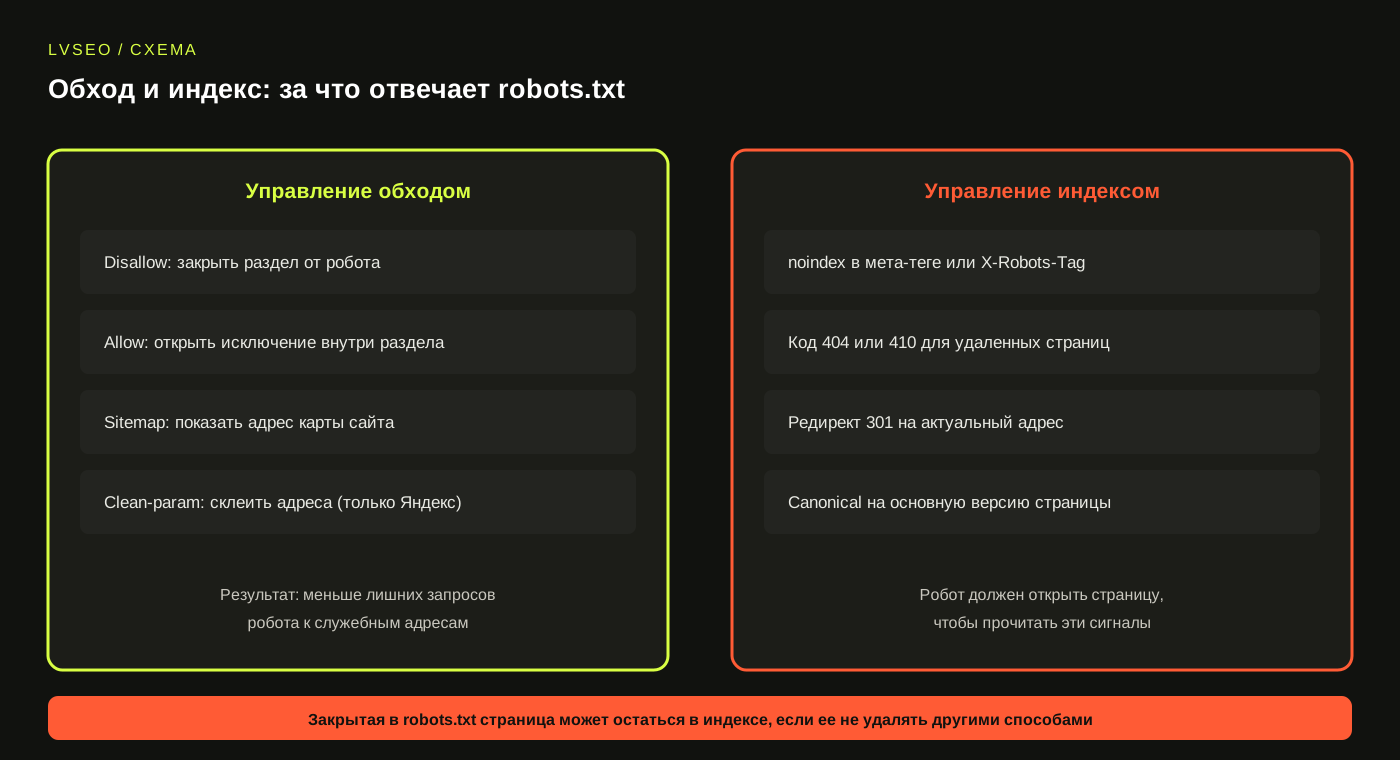
Главное, что нужно запомнить: robots.txt управляет обходом, а не индексацией. Директива Disallow говорит роботу «не заходи на эту страницу», но не говорит поисковику «забудь про этот адрес». Если на закрытую страницу ведут ссылки с других сайтов или из вашей навигации, она вполне может попасть в выдачу, только без описания и с пометкой, что содержимое недоступно.
Поэтому у файла две реальные задачи. Первая – не дать роботу тратить время на страницы, которые не нужны в поиске: корзину, личный кабинет, результаты внутреннего поиска, технические параметры. Вторая – указать адрес карты сайта. Все остальное, что от него ждут, он не выполняет: не удаляет страницы из индекса, не защищает данные и не скрывает ничего от людей. Файл публичный, его может открыть любой, поэтому прятать в нем адреса закрытых разделов вроде админки по меньшей мере наивно.
Когда страницу нужно именно убрать из поиска, работают другие инструменты: мета-тег robots со значением noindex, заголовок X-Robots-Tag, код ответа 404 или 410, перенаправление, canonical. Важная тонкость: робот должен иметь возможность открыть страницу, чтобы увидеть noindex. Если вы закрыли ее в robots.txt, этот тег он не прочитает, и адрес может висеть в индексе месяцами.
- закрывает от обхода: разделы, фильтры, служебные адреса, параметры
- не удаляет из индекса: для этого нужен noindex, код 404 или 410
- не защищает информацию: для конфиденциальных данных нужна авторизация
- не гарантирует послушание: добросовестные роботы соблюдают правила, остальные могут их игнорировать
Где должен лежать файл и как его читают роботы
Файл называется строго robots.txt, в нижнем регистре, и лежит в корне сайта: адрес вида https://ваш-сайт.ru/robots.txt. В подпапке он не работает. Правила действуют только для того хоста, протокола и порта, где файл размещен, поэтому у поддомена blog.ваш-сайт.ru должен быть собственный файл, а у версий сайта с www и без www ответ должен быть одинаковым.
Кодировка – UTF-8 или ASCII, по одной директиве в строке. Размер лучше держать в разумных пределах: Google читает первые 500 КиБ, остальное отбрасывает, а Яндекс при размере больше 32 КБ может воспринять файл как разрешающий все. Если ваш файл приближается к этим цифрам, он слишком раздут и его пора упрощать.
Огромное значение имеет код ответа. Если robots.txt отдает 404, роботы считают, что запретов нет, и ходят везде. Если сервер возвращает ошибку 5xx, Google на время считает весь сайт закрытым и перестает обходить его, пока ошибка не уйдет. Редирект на другую страницу или ответ 200 с HTML вместо текста тоже ломают разбор. Проверка занимает десять секунд, и делать ее стоит после каждого релиза и переезда.
curl -sI https://ваш-сайт.ru/robots.txt | head -n 5
curl -s https://ваш-сайт.ru/robots.txt | head -n 30Директивы и синтаксис: как настроить robots.txt без ошибок
Файл состоит из групп правил. Каждая группа начинается со строки User-agent, где указано, для какого робота она написана, и дальше идут директивы Disallow и Allow. Звездочка в User-agent означает «для всех роботов». Если для конкретного робота есть отдельная группа, он читает только ее и общую группу уже игнорирует, поэтому общие запреты в такой группе приходится повторять.
В путях работают два спецсимвола. Звездочка заменяет любую последовательность знаков, а знак доллара фиксирует конец адреса. Правило Disallow: /*.pdf$ закроет адреса, оканчивающиеся на .pdf, а Disallow: /search закроет все, что начинается с /search. Пустое значение Disallow: без пути ничего не запрещает.
Когда правила пересекаются, побеждает более конкретное, то есть более длинный путь. Если закрыт раздел /catalog/, а внутри него открыт /catalog/public/, то страницы public будут доступны. Именно поэтому Allow нужен, чтобы вырезать исключения из большого запрета. Порядок строк при этом значения не имеет, поэтому не рассчитывайте, что нижняя строка отменяет верхнюю.
Если правил накопилось много и вы не уверены, что они не конфликтуют, проверку файла можно включить в SEO-аудит сайта – там robots.txt разбирается вместе с индексацией, картой сайта и кодами ответа.
Что закрывать на обычном сайте
Исходите из простого вопроса: нужна ли эта страница человеку, который пришел из поиска? Если нет, роботу ее тоже обходить незачем. Для сайта услуг или корпоративного сайта на WordPress, Битриксе или другой CMS обычно закрывают небольшой стабильный набор адресов.
Не пытайтесь закрыть «на всякий случай» все подряд. Каждый лишний запрет – это потенциально потерянный трафик, а аудит чужих файлов регулярно показывает, что половина строк осталась от прежних разработчиков и давно не нужна.
User-agent: *
Disallow: /admin/
Disallow: /login
Disallow: /search
Disallow: /cart
Disallow: /order
Disallow: /*?utm_
Disallow: /*?yclid=
Disallow: /*?gclid=

Sitemap: https://ваш-сайт.ru/sitemap.xml- админка и служебные разделы CMS, если они доступны по адресу без авторизации
- страницы входа, регистрации, восстановления пароля
- результаты внутреннего поиска по сайту
- версии для печати и дубли страниц по служебным адресам
- корзину, оформление заказа, личный кабинет
- адреса с идентификаторами сессий и метками рекламных систем (utm, yclid, gclid)
- тестовые и черновые разделы, если их нельзя спрятать паролем
Часть таких адресов создает дубли основных страниц, и закрытием от обхода их проблему не решить – как с этим работать, разобрано в статье про дубли страниц сайта там же показано, где нужен canonical, а где редирект.
Настройка robots.txt для интернет-магазина: фильтры, сортировки, пагинация
В каталоге интернет-магазина основной объем мусора создают фильтры, сортировки и параметры. Один раздел с пятью фильтрами порождает тысячи комбинаций, и без ограничений робот легко потратит на них большую часть обхода, а новые товары будут ждать своей очереди неделями.
Здесь нужна не слепая блокировка, а различение. Фильтры, которые совпадают с реальным спросом, например «зимние шины 205/55 R16», лучше оформить отдельными страницами с понятным адресом, названием и текстом и оставить открытыми. Все остальные комбинации и сортировки стоит закрыть. Сортировка по цене или популярности не создает нового спроса, она только переставляет те же товары.
Пагинацию закрывать целиком не нужно: по страницам списка робот находит товары, которые иначе никак не связаны с остальным сайтом. Лучше сделать так, чтобы каждая страница списка открывалась по своему адресу и ссылалась на следующую. Для параметров, которые не меняют содержимое, у Яндекса есть собственная директива Clean-param, о ней дальше.
User-agent: *
Disallow: /*?sort=
Disallow: /*?view=
Disallow: /*&sort=
Disallow: /*?filter=
Allow: /catalog/*?page=

Sitemap: https://ваш-сайт.ru/sitemap.xmlКак отделять фильтры, которые приносят заявки, от тех, что только расходуют обход, я разбираю в работе по SEO интернет-магазина с этого начинается работа с каталогом на несколько тысяч адресов.
Яндекс и Google: чем отличается настройка robots.txt
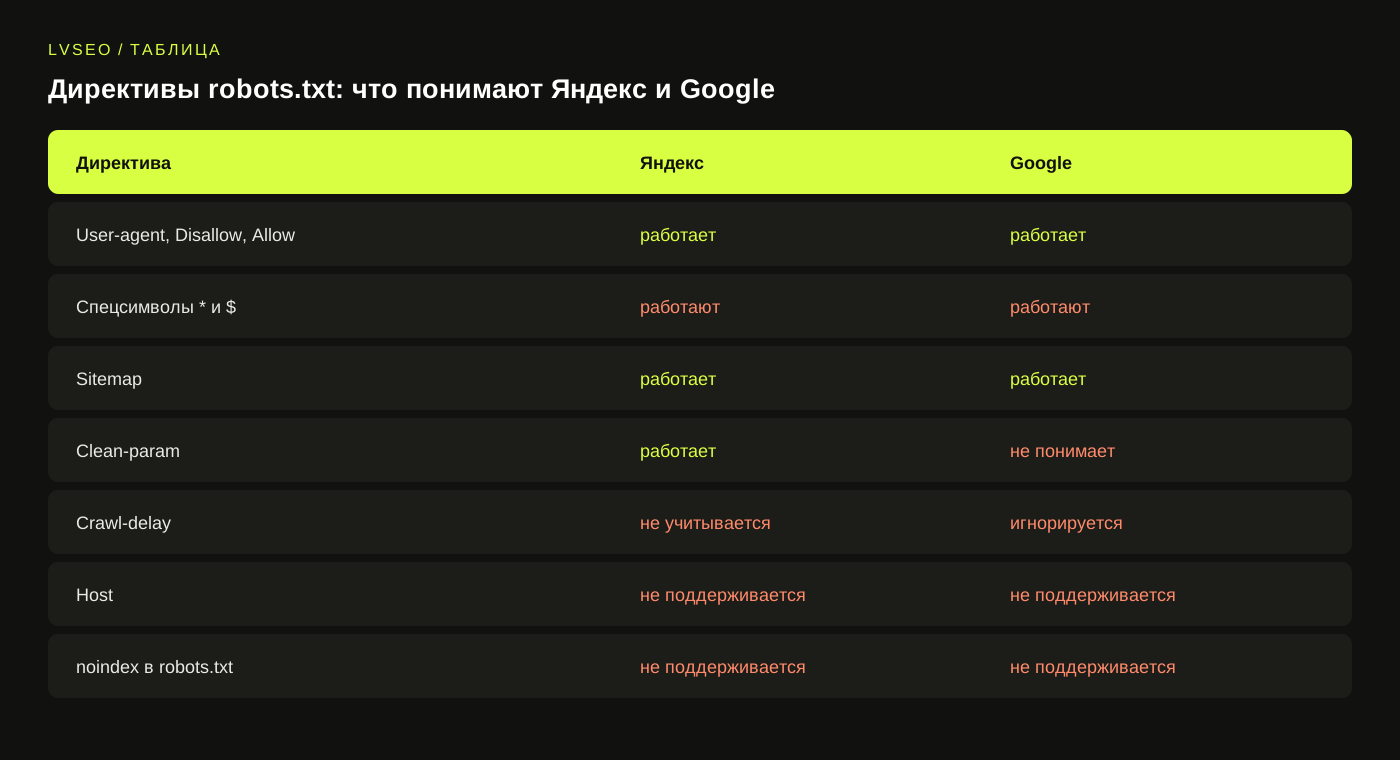
Основной синтаксис у двух поисковиков общий, но есть расхождения, на которых чаще всего ошибаются. Первое – Clean-param. Эту директиву понимает только Яндекс: она сообщает, что параметр в адресе не влияет на содержимое, и робот склеивает такие адреса в один. Google о ней не знает и просто пропускает строку, поэтому для него параметры закрывают через Disallow или решают через canonical.
Второе – Crawl-delay. Раньше она задавала паузу между запросами. Сегодня Google ее игнорирует, а Яндекс перестал учитывать эту директиву и предлагает регулировать скорость обхода в Вебмастере. Если вы видите Crawl-delay в чужом файле, это следы прошлых лет, и вреда от нее нет, но и пользы тоже. Третье – Host: она указывала главное зеркало, давно не поддерживается, а главное зеркало определяется редиректом и настройкой в Вебмастере.
Практический вывод: отдельную группу для Yandex заводят, только если нужен Clean-param. И помните про правило группы: роботы Яндекса, найдя блок User-agent: Yandex, перестанут читать общий, поэтому все запреты из блока со звездочкой нужно продублировать. Это самая частая причина того, что закрытые для всех страницы продолжают обходиться Яндексом.
User-agent: Yandex
Disallow: /admin/
Disallow: /search
Clean-param: utm_source&utm_medium&utm_campaign /

User-agent: *
Disallow: /admin/
Disallow: /search

Sitemap: https://ваш-сайт.ru/sitemap.xmlЧего нельзя закрывать и как правильно убрать страницу из поиска
Первое правило: не закрывайте стили, скрипты и изображения, которые нужны для отрисовки страницы. Робот должен увидеть сайт так же, как посетитель, иначе он не поймет, что страница удобна для мобильных, и не оценит ее содержимое. Особенно это опасно для сайтов на JavaScript, о которых я писал в отдельной статье.
Второе правило: не закрывайте то, что нужно вывести из индекса через canonical, редирект или noindex. Робот не сможет прочитать эти сигналы с закрытой страницы, и адрес останется в выдаче. Типичный сценарий: вы переехали на новые адреса, настроили редиректы, но старый раздел оставили закрытым в robots.txt. Поисковик не видит редирект и годами держит старые страницы.
Третье правило: карту сайта и сам файл robots.txt закрывать нельзя, а в карту не должны попадать закрытые адреса. Если в sitemap.xml лежат URL, которые запрещены к обходу, Вебмастер и Search Console сразу покажут конфликт, и это сигнал, что файл или карту пора править.
Если страницы не попадают в поиск, а причина не очевидна, начните с диагностики по статье про индексацию сайта там разобраны все этапы от обхода до показа и порядок проверки.
Как проверить robots.txt до и после правок
Любую правку файла проверяйте до выкладки на рабочий сайт. В Яндекс Вебмастере есть инструмент «Анализ robots.txt»: в него можно вставить новый вариант текста и список адресов и увидеть, разрешены они или запрещены. В Google Search Console в разделе настроек есть отчет о файле robots.txt: он показывает, какую версию робот скачал, когда, и какие ошибки в ней нашел.
Составьте контрольный список адресов, которые должны оставаться открытыми при любых правках. Для типичного сайта это главная, две-три страницы услуг, категория каталога, карточка товара, статья блога и страница с фильтром, который держит спрос. После каждого изменения прогоняйте этот список через проверку. Если хоть один адрес закрылся, правка не выкладывается.
Через неделю-две после выкладки сверьтесь с реальностью. В Вебмастере смотрите число страниц в поиске и исключенные страницы с причиной «запрещено в robots.txt», в Search Console – отчет по индексации страниц. Если число закрытых адресов выросло сильнее, чем вы планировали, значит правило оказалось шире задуманного. По серверным логам видно, перестал ли робот ходить на закрытые разделы и куда перераспределились его запросы.
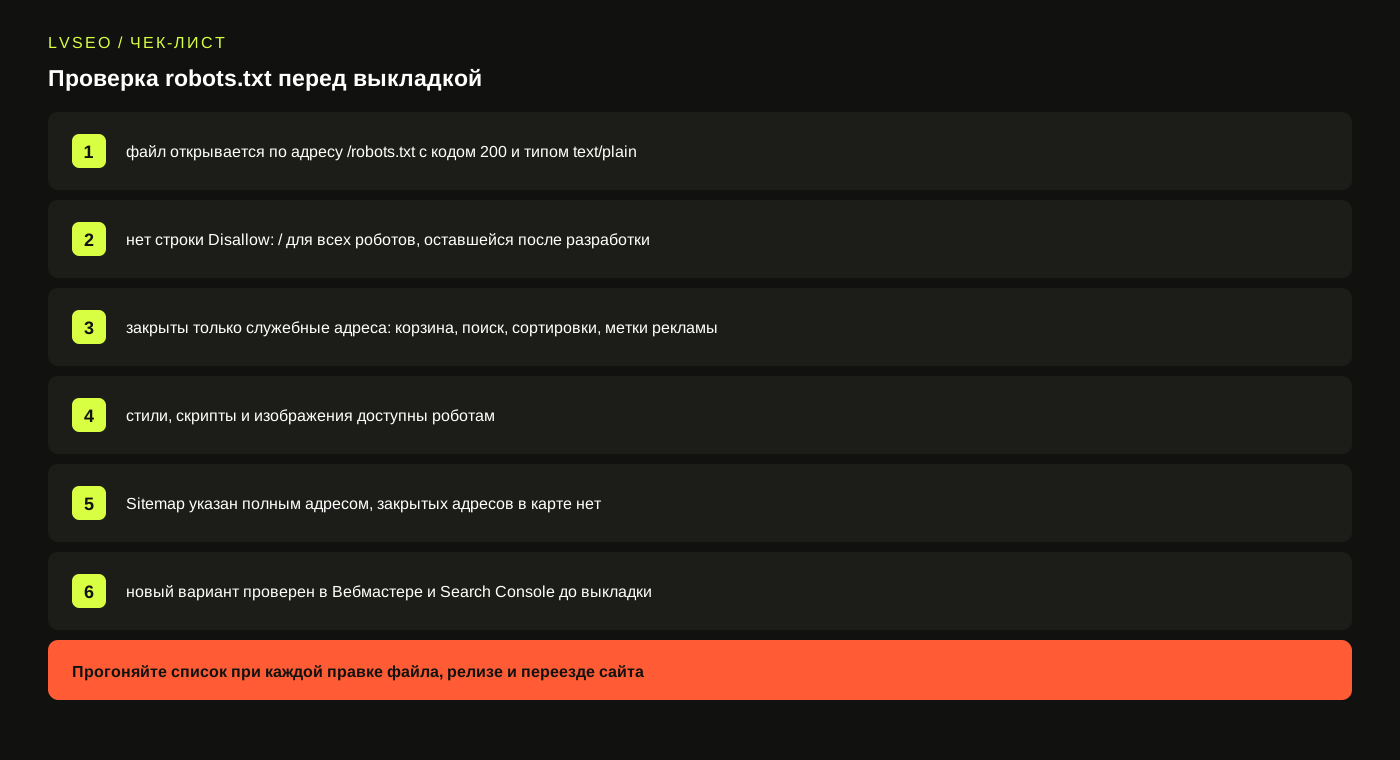
- файл открывается по адресу /robots.txt с кодом 200 и типом text/plain
- в Вебмастере и Search Console нет ошибок разбора файла
- все адреса из контрольного списка разрешены
- Sitemap указан с полным адресом и совпадает с реальной картой
- закрытые адреса не попадают в sitemap.xml
- стили, скрипты и изображения доступны роботам
Как техническая проверка каталога сочетается с работой над запросами и посадочными страницами, видно в кейсе SEO интернет-магазина шин в Москве там показана недельная динамика поискового трафика за весь срез.
Частые ошибки и что делать в итоге
Самая дорогая ошибка – оставленный после разработки запрет Disallow: / на всем сайте. Его ставят на тестовом стенде, а при переносе на боевой домен файл едет вместе с остальным кодом. Заметить это можно по падению трафика через несколько дней, а исправление возвращает показы не сразу. Вносите проверку файла в чек-лист каждого релиза и переезда.
Вторая частая ошибка – слишком широкое правило с шаблоном. Строка Disallow: /*? закроет все адреса с параметрами, включая пагинацию и полезные фильтры. Третья – попытка использовать robots.txt как инструмент удаления: страницы закрыты, а в поиске остаются. Четвертая – копирование чужого файла: правила составлены под другую CMS и другую структуру, и половина строк бессмысленна, а часть вредна.
- откройте свой файл прямо сейчас и убедитесь, что там нет Disallow: / для всех роботов
- уберите устаревшие директивы Host и Crawl-delay и правила, оставшиеся от старой структуры
- закройте только служебное: корзину, поиск, сортировки, метки рекламы
- оставьте открытыми стили, скрипты, изображения и страницы с реальным спросом
- укажите полный адрес карты сайта директивой Sitemap
- проверьте новый вариант в Вебмастере и Search Console до выкладки и через две недели после