Почему список ключевых слов – это еще не ядро
Частая ошибка – спутать семантическое ядро с длинным списком фраз из Вордстата или Key Collector. Список без интента и группировки не решает задачу: непонятно, какая страница должна отвечать на запрос, сколько таких страниц нужно и что делать с формулировками, которые формально про ваш продукт, но приводят не тех людей.
Готовое ядро отвечает на три вопроса: что именно ищут клиенты, каким смыслом объединены разные формулировки одного и того же запроса и на какую страницу сайта должен попасть человек с каждой фразой. Пока хотя бы один из ответов отсутствует, работа не закончена. Дальше показываю процесс на примере частной стоматологии – но шаги одинаковы для услуг, интернет-магазина и B2B-сайта.
Шаг 1. Соберите маркерные запросы
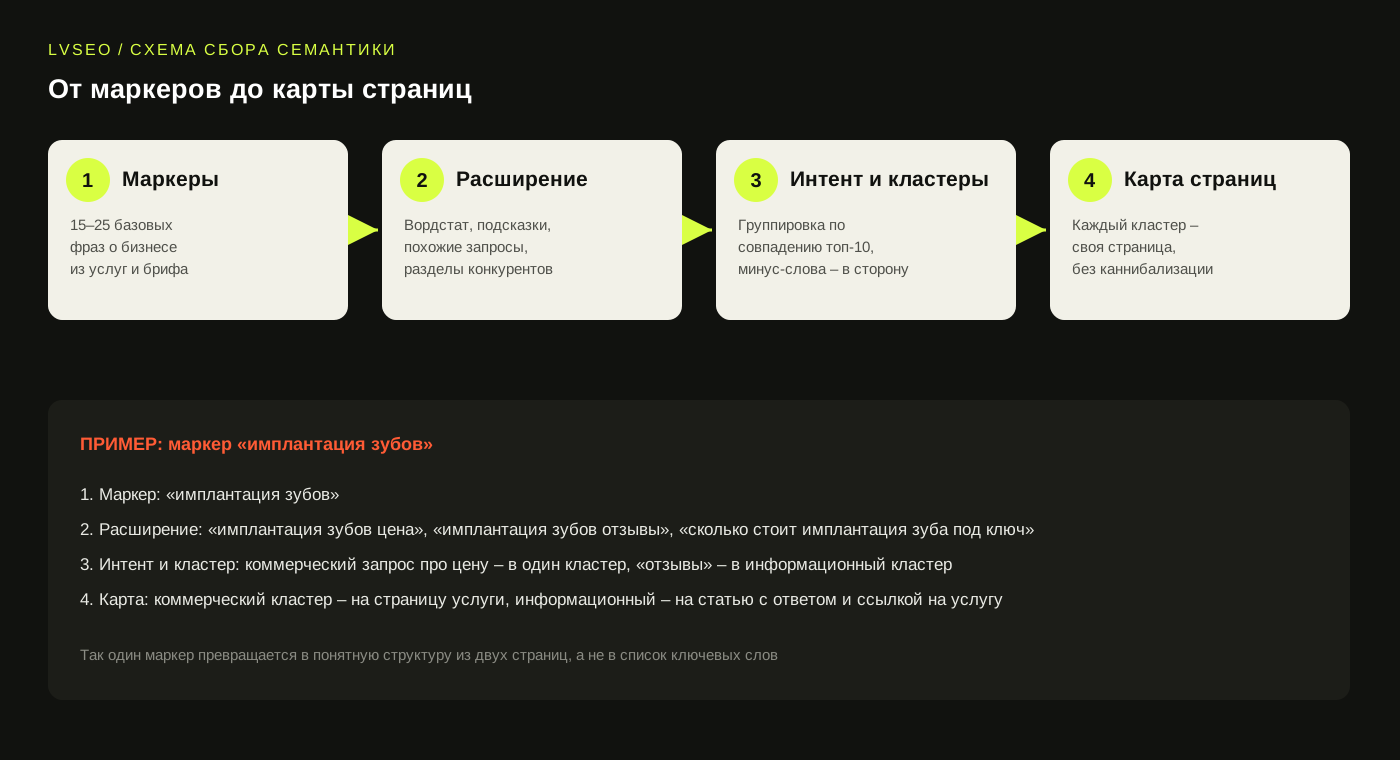
Ядро начинается не со сбора всех возможных слов, а с 15–25 маркерных фраз – коротких формулировок, которые описывают бизнес так, как его назвал бы клиент. Маркеры беру из четырех источников: список услуг или товаров, формулировки из брифа клиента, разделы сайтов трех-пяти конкурентов и вопросы, которые реально звучат в переписке и на консультациях. Для стоматологии маркерами станут не «стоматология» и «зубы», а «имплантация зубов», «лечение кариеса», «брекеты для взрослых» – по одному маркеру на каждое направление, которое продает клиника.
- названия услуг и товаров своими словами, а не только юридическими терминами
- синонимы и разговорные формулировки: «продвижение сайта» и «раскрутка сайта»
- аудитория и ситуация: «SEO для интернет-магазина», «SEO после переезда сайта»
- география, если бизнес работает в одном или нескольких регионах
Шаг 2. Расширьте ядро по трем источникам
Каждый маркер разворачивается в десятки связанных формулировок. Использую три источника, и ни один не заменяет остальные: частотность Яндекс Вордстата с фразами в кавычках и с восклицательным знаком перед каждым словом – так видно точное число показов, а не сумму по всем словоформам; подсказки и блок «Похожие запросы» в выдаче Яндекса и Google; структуру разделов у сайтов, которые уже стоят в топ-10 по вашим маркерам. Для маркера «имплантация зубов» Вордстат в кавычках покажет отдельно частотность самой фразы, а без кавычек – вместе с «имплантация зубов цена», «имплантация зубов отзывы» и еще десятками хвостов, которые стоит выписать отдельно.
На этом шаге собираю с запасом: лучше на следующем этапе убрать полтора десятка нерелевантных фраз, чем на старте пропустить формулировку, по которой реально ищут ваш продукт. Для среднего сайта услуг на выходе получается 150–400 фраз, для интернет-магазина с широким ассортиментом – несколько тысяч. Регион в Вордстате всегда выставляю тот, для которого продвигаю сайт: частотность по России и по одному городу может отличаться в разы.
Шаг 3. Определите интент каждого запроса
Интент – это то, что человек хочет получить: информацию, конкретный сайт, сравнение вариантов или покупку прямо сейчас. Частая ошибка – посадить на одну страницу услугу и информационный запрос вроде «сколько стоит имплантация зуба под ключ»: они конкурируют за разную выдачу и разную аудиторию, и общая страница проигрывает обоим направлениям.
Интент проверяется просто: откройте выдачу по запросу и посмотрите, какие страницы занимают топ-10 – статьи, карточки товаров, каталоги или сайты компаний. Если девять из десяти результатов – статьи с объяснением термина или ценами по рынку, туда же должна попасть и ваша страница; тянуть в топ продающую страницу клиники по такому запросу бессмысленно, зато можно закрыть его отдельной статьей со ссылкой на услугу.

Шаг 4. Кластеризация: группируйте по выдаче, а не по своей логике
Кластеризация объединяет запросы, по которым поисковик показывает похожую выдачу: если у двух фраз в топ-10 совпадает 5–7 адресов из десяти, им, скорее всего, нужна одна страница. Если совпадает меньше 3 адресов, разводите фразы по разным страницам – общая страница ответит на оба вопроса лишь наполовину. Для небольшого ядра сверяю топ-10 вручную; для тысяч фраз использую сервисы кластеризации, но итоговые границы кластеров все равно проверяю сама – автоматика ошибается на многозначных словах.
Группировка по смыслу без проверки выдачи подводит там, где интуиция расходится с тем, как запрос понимает поисковик. Формулировки «продвижение сайта в Яндексе» и «продвижение сайта в поисковых системах» кажутся синонимами, но у первой в выдаче часто больше сервисов и статей про рекламу в Яндекс Директе, а не про SEO – объединять их в один кластер без проверки рискованно.
Шаг 5. Уберите мусор и минус-слова
После кластеризации в ядре обычно остается 5–15% фраз, которые не приведут клиентов. Их стоит вынести в отдельный список минус-слов и минус-фраз, а не просто удалить – так следующий сбор семантики не наступит на те же грабли.
- вакансии и обучение: «стоматолог вакансии», «курсы имплантологии»
- бесплатные и самостоятельные варианты: «как снять брекеты самому в домашних условиях»
- чужие бренды и сервисы, если вы их не продаете и не сравниваете
- нецелевая география – города и страны, где бизнес не работает
- фразы с нулевыми показами за последние полгода – ставить их в приоритет рано
Частые ошибки при сборе семантики
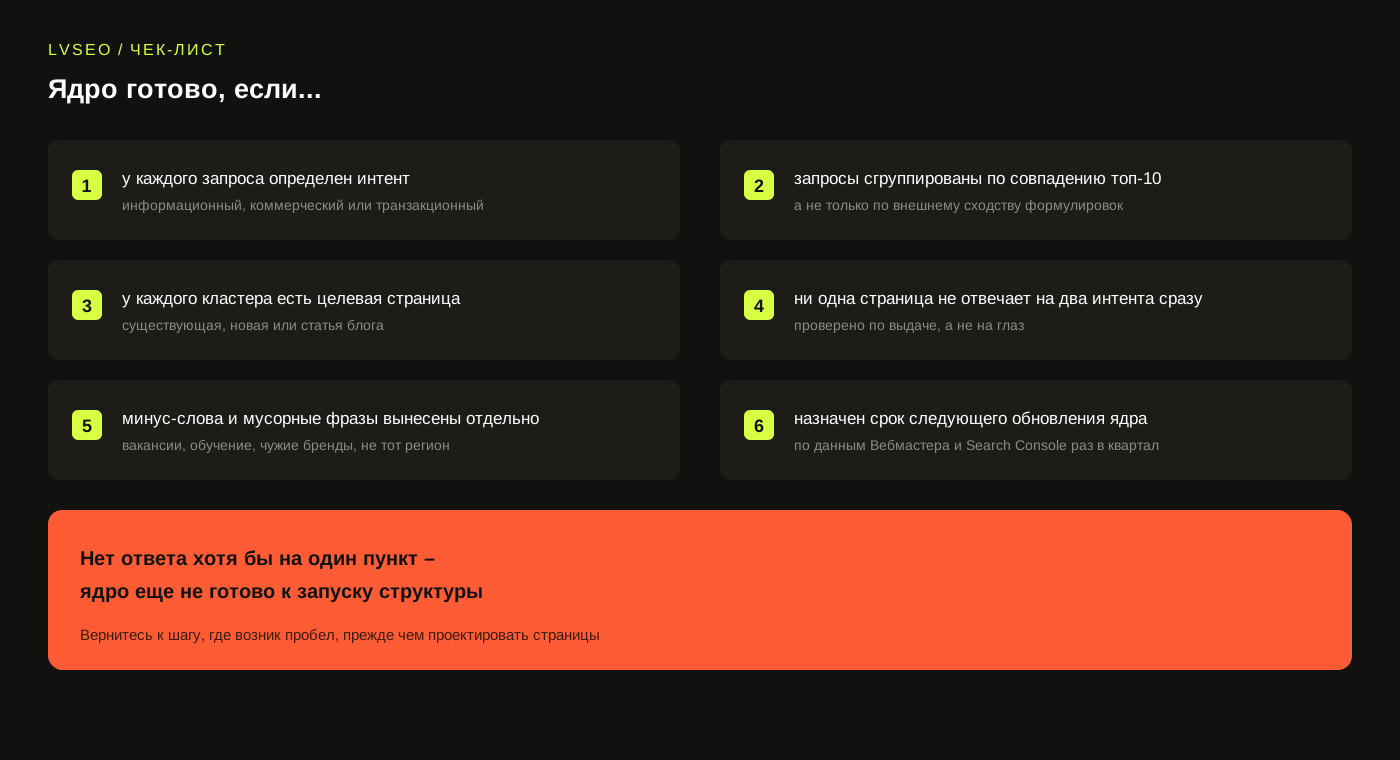
Три ошибки встречаются чаще остальных, и все три вскрываются на этапе проверки, а не сбора.
- одна страница отвечает на несколько разных интентов и не занимает высоких позиций ни по одному из них
- несколько страниц сайта конкурируют за один и тот же кластер – это называется каннибализацией запросов, и поисковик сам решает, какую страницу показать, а не всегда угадывает верно
- ядро собрано один раз и не обновляется, хотя в Вебмастере и Search Console каждый месяц появляются новые формулировки спроса
С чего начать
Если сайт уже работает, начните не со сбора с нуля, а с выгрузки запросов, по которым он уже получает показы в Яндекс Вебмастере и Google Search Console – это готовая часть ядра с проверенным спросом. Дальше добавляйте маркеры, которые сайт пока не покрывает, и распределяйте новые кластеры по существующим и новым страницам. Раз в квартал стоит повторять выгрузку показов и добавлять в ядро формулировки, которых не было при первом сборе, – спрос меняется быстрее, чем кажется.
Если нужно собрать и кластеризовать ядро для вашего сайта, сбор семантического ядра включает частотность, интенты и карту страниц.